生物無窮小——有機數據庫
生物無限 - 有機資料庫
化學博士。工程。西普里安-加布里埃爾·奇塞加-內格里爾
座右銘:
一開始很簡單。解釋宇宙的起源是相當困難的,無論它多麼簡單。我想每個人都接受這樣的觀點,即解釋具有所有必要設備的複雜秩序(生命)或能夠創造生命的存在的突然出現更加困難。達爾文的自然選擇進化論令人滿意,因為它向我們展示了一種將簡單轉化為複雜的方法,一些無序的原子如何組合成越來越複雜的結構,直到最終創造出人類。
理查‧道金斯 (Richard Dawkins) – 《自私的基因》,第二章 – 複製者,第 14 頁14,布加勒斯特,技術版,2001 年(譯:Dan Crăciun)
一、摘要
逆滲透: 本文主要描述了真核細胞的結構以及細胞質和細胞核的子結構,以幫助理解脫氧核糖核酸/DNA 如何作為包含細胞生長和繁殖所需的所有資訊的資料庫發揮作用。它也描述了 DNA 中包含的訊息被轉錄為核糖核酸/RNA,然後用作核醣體內蛋白質合成模板的機制。文章的架構是描述真核細胞基本訊息的元文本之一,真核細胞是高等生物(包括人類)的組成部分。為了更好地理解所處理的主題,代表深入資訊和參考書目連結的二維碼已插入到文本中。
英語: 本文主要描述了真核細胞的結構以及細胞質和細胞核內的子結構,以幫助理解脫氧核糖核酸 (DNA) 如何作為包含細胞生長和繁殖所需所有資訊的資料庫發揮作用。它還解釋了 DNA 中包含的訊息被轉錄為核糖核酸 (RNA),然後用作核醣體內蛋白質合成模板的機制。這篇文章的結構是一種元文本,提供了有關真核細胞的基本資訊——高等生物體(包括人類)的組成部分。為了更好地理解該主題,文本中包含了二維碼,可提供深入的資訊和參考書目。
關鍵字: 生物體、細胞、DNA、RNA、蛋白質、資料庫
二.介紹
我們所居住的地球已有大約 45 億年的歷史。會很多嗎?會不會有一點?事實上,它幾乎是宇宙年齡的三分之一。大約 40 億年前,第一種生命形式以單細胞原核生物的形式出現。這種細胞類型包括細菌和古細菌綱的成員。它們的特徵是沒有細胞核,但有鞭毛(大多時候)、細胞膜、細胞質、核醣體和含有分散在細胞質中的遺傳訊息的核苷酸。
II.a.真核生物
真核生物是比原核生物複雜得多的生物。與原核細胞相比,真核細胞約大一萬倍。單細胞和多細胞真核生物都可以包括在這一類中。它們是屬於動物(如人類)、植物(如玉米)和真菌(如香菇)的細胞。
該類的其他代表有:黴菌、原生動物和藻類。
II.b.真核細胞的組成部分
真核細胞描述於 圖1。
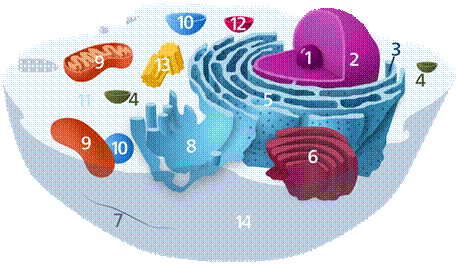
圖1 – 真核細胞的結構:1 – 核仁,2 – 細胞核,3 – 核醣體,4 – 囊泡,5 和 8 – 內質網,6 – 高爾基體,7 – 細胞骨架,9 – 粒線體,10 – 液泡,11 – 細胞質,12 – 溶小體,13 – 中心體,14 –細胞膜
它由以下組件組成(圖1):
- 膜 (14) – 它覆蓋細胞、控制物質進入或離開細胞並維持其電位;
- 細胞質-是一種凝膠狀環境,佔據了膜所包圍的大部分空間。它包含以下 12 項所描述的細胞質內亞結構:
- 核仁 (1) 是真核細胞細胞核中最大的結構。已知它是核醣體生物發生發生的場所;
- 細胞核 (2) – 包含幾乎 99% 的細胞基因組/資料庫。這是脫氧核糖核酸-核DNA(紅血球/紅血球中不存在)的所在地。它主要以染色體的形式組織/包裝。細胞所需的所有資訊都儲存在這裡。我們將進一步回到這個主題!
- 核醣體 (3) – 細胞質的子結構,其中以 DNA/RNA 訊息作為模板進行蛋白質合成;
- 囊泡 (4) – 細胞內部或外部的結構,含有雙層脂質包裹的液體或細胞質。它有助於物質從細胞中去除或進入細胞,以及物質跨膜運輸;
- 內質網(5 和 8)-是真核細胞運輸系統的一部分,具有蛋白質折疊/包裝等功能;
- 高爾基體 (6) – 在蛋白質被送到目的地之前將其嵌入囊泡中發揮著非常重要的作用;
- 細胞骨架 (7) – 是一個由相互連接的蛋白質絲組成的複雜且動態的網絡。在真核細胞內,它從細胞核延伸到細胞膜。賦予電池抗變形能力。它也參與許多其他細胞過程。
- 粒線體 (9) – 用於在 ATP(三磷酸腺苷)分子中以化學形式產生和儲存能量;
- 液泡 (10) – 是細胞質中的封閉隔間,可以含有無機或有機物質(通常是酵素溶液,在極少數情況下是固體物質);
- 細胞質 (11) – 也稱為細胞質基質。它是溶解在大量水中的複雜物質混合物;
- 溶小體 (12) – 它們是存在於許多動物細胞中的球形囊泡。它們含有水解酶,可以消化各種生物分子;
- 中心體 (13) – 是一種具有複雜功能的細胞器。
三.脫氧核糖酸 – DNA – 有機資料庫
DNA 是一種非常複雜的有機分子,但我會盡力盡可能簡單地解釋它!它是在 19 世紀初由瑞士生物化學家 Frederich Miesher 發現的(他,DNA ...☺),但直到 1953 年詹姆斯·沃森、弗朗西斯·克里克、莫里斯·威爾金斯和羅莎琳德·富蘭克林才破譯了它的結構,他們借助當時的新技術——X 射線衍射研究了這種分子。四位科學家證明DNA由兩個相互「扭曲」的雙螺旋組成,即所謂的α螺旋。
DNA所在的地方是細胞核(圖1),它以代表染色體的幾個 X 形結構的形式包裝(並超級存檔)。具體來說,人類有 46 條這樣的染色體,分成 23 對。這樣的 22 對稱為常染色體,在雌性 (♀) 和雄性 (♂) 中具有相似的結構,第 23 對不同,因為它編碼有關生物體性別的資訊。
我之前談到的所有這些包裝意味著,一個自由的分子,其長度接近2米的「巨大」(分子通常具有奈米甚至微米量級的尺寸)可以被存檔在奈米量級的空間中(這大約是正常真核細胞的細胞核的大小)。包裝是在稱為組蛋白的小分子的幫助下完成的。為了解釋清楚,我在中提供了詳細的圖形表示 圖2。
據觀察,在由糖分子(脫氧核糖,為了完整起見…與RNA中的核糖相似的糖…但失去了羥基-OH基團)和磷酸鹽形成的骨架上, 圖3-4 (源自 ATP-我們先前在簡單介紹粒線體時所討論的三磷酸腺苷:位置 (9) 圖1)是核鹼基,遺傳字母的 4 個字母:A – 腺嘌呤、C – 胞嘧啶、G – 鳥嘌呤和 T – 胸腺嘧啶(圖4)。這些來自遺傳字母表的字符一次組合兩個,以連接 DNA 分子的兩條鏈。腺嘌呤 (A) 與胸腺嘧啶 (T),透過 2 個氫鍵,A === T 和胞嘧啶 (C) 與鳥嘌呤,透過 3 個氫鍵,C ==== G (圖3-4)。
序列中的幾個核鹼基組成了一個基因,而基因包含了細胞生長和繁殖所需的所有資訊。細胞繁殖時的 DNA 複製不是本文的主題...
其中許多基因編碼蛋白質(一串串的胺基酸長序列),這些蛋白質可以是:酵素、運輸物質、荷爾蒙甚至神經傳導物質(例如在兩個神經元之間的突觸空間中)。 DNA 也編碼精子受精的卵子生長和發育所需的訊息,直到獲得功能齊全的有機體的那一刻 ....但關於這一點在下一章......
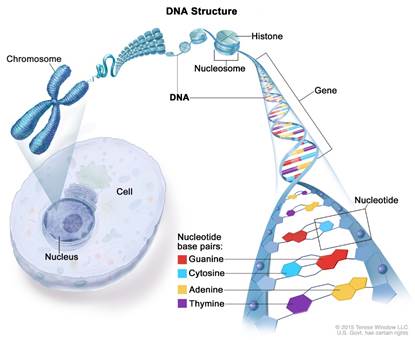
圖2 – DNA 在細胞核中的位置及其包裝
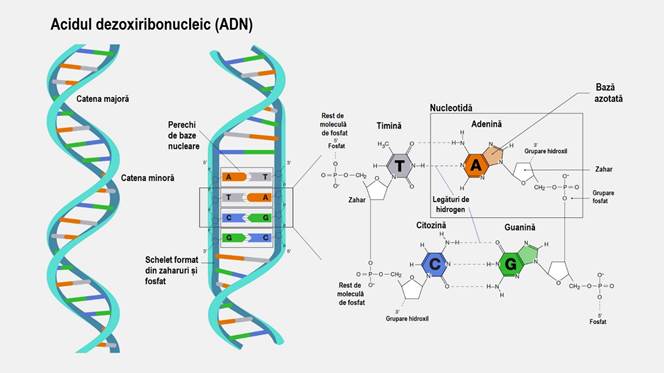
圖3 – 包含兩個捲曲螺旋(α-螺旋)和核鹼基的細節:腺嘌呤 (A)、透過 2 個氫鍵結合的胸腺嘧啶 (T) A === T、胞嘧啶 (C)、透過 3 個氫鍵結合的鳥嘌呤 (G) C == G
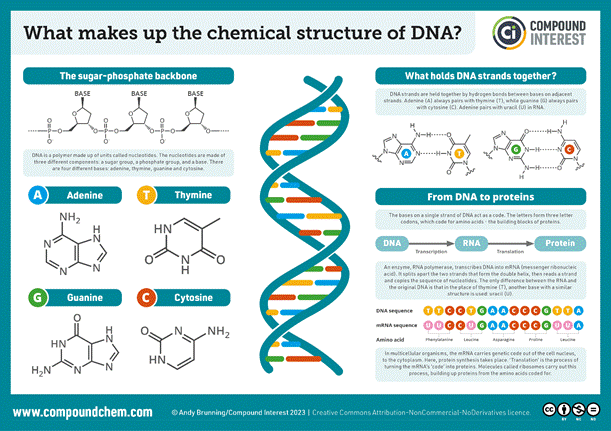
圖4 – 核子基地的結構和兩條主鏈的骨架
四. RNA – 核糖核酸胞內轉運蛋白
RNA 是一種比 DNA 稍微簡單的分子。如果DNA有兩條相互纏繞的鏈,那麼RNA就只有一條鏈。 RNA 鏈主鏈中的糖稱為核糖,如上一小節所述。 RNA字母表仍然有4個字符,但有一個鹼基與DNA中的不同。因此,有:腺嘌呤(A)、胞嘧啶(C)、鳥嘌呤(G)和尿嘧啶(U)。請注意,胸腺嘧啶不再出現在該字母中。因此,當DNA轉錄為RNA時,胸腺嘧啶被尿嘧啶取代:腺嘌呤被轉錄為尿嘧啶,胞嘧啶被轉錄為鳥嘌呤,鳥嘌呤被轉錄為胞嘧啶,胸腺嘧啶被轉錄為腺嘌呤。
RNA的主要作用是將訊息從細胞核中的DNA攜帶到細胞質中的核醣體,在那裡它被用來合成細胞在任何給定時間所需的蛋白質。
RNA 有多種類型:
- 信使RNA-將編碼訊息從DNA攜帶到核醣體;
- 轉移RNA-參與蛋白質(核醣體內)中胺基酸有序連接在一起的機制…但我在這裡不會詳細介紹;
- ARN 核醣體等
對於來自DNA上編碼基因的訊息的轉座機制(在真核生物中-包括人類-幾乎97%的DNA訊息在蛋白質合成中沒有作用)我將只進一步討論信使RNA-mRNA。
V. 將訊息從 DNA 轉錄為蛋白質(胺基酸序列)
正如我們之前所說,信使 RNA(mRNA)是細胞內訊息的載體。當需要轉錄基因訊息時,一種稱為 RNA 聚合酶的酵素就會附著在 DNA 結構上。這會解開兩條鏈,並使核鹼基相距 10 – 20 個字元(A、T、G、C)。進行轉錄的鏈稱為模板(反義)鏈,另一個非模板(編碼)鏈。 DNA 上的鹼基如前所述轉錄:腺嘌呤 (A) 為尿嘧啶 (U),胞嘧啶 (C) 為鳥嘌呤 (G),鳥嘌呤 (G) 為胞嘧啶 (C),胸腺嘧啶 (T) 為腺嘌呤 (A)。
例如(這裡我們採用了 27 個字符,但轉錄的基因通常更長):
如果在編碼鏈上我們有:
| 一個 | 時間 | G | C | G | G | C | 一個 | C | G | 一個 | 時間 | 時間 | 時間 | C | C | 時間 | G | 一個 | 一個 | C | C | C | G | 時間 | G | 一個 |
在對應模板鏈上產生:
| 時間 | 一個 | C | G | C | C | G | 時間 | G | C | 時間 | 一個 | 一個 | 一個 | G | G | 一個 | C | 時間 | 時間 | G | G | G | C | 一個 | C | 時間 |
RNA鏈被轉錄:
| 一個 | U | G | C | G | G | C | 一個 | C | G | 一個 | U | U | U | C | C | U | G | 一個 | 一個 | C | C | C | G | U | G | 一個 |
它被稱為 mRNA 或信使 RNA。
此時,我們繼續進行 mRNA 處理,因為並非所有資訊都是編碼的。 mRNA 的某些部分將被排除,這些部分稱為內含子,剩餘的序列稱為外顯子。這些外顯子聚集在一起形成訊息,這些訊息將到達核醣體進行蛋白質合成。這裡讀取序列上的“字母” 一次 3 個並表示為單一胺基酸。這些字符有64種組合,而氨基酸只有20個,這意味著一個氨基酸可以由多組3個字符編碼。有一個 START 組合:AUG 和 3 個 STOP 組合:UAA、UAG 和 UGA。但是氨基酸將在拉丁字母表中的下一個字符序列中討論!
V.a.氨基
人類遺傳學中有 20 種氨基酸,每種氨基酸都有自己的化學式,如 圖5 並在 表1 從續集。所有這些胺基酸的共同點:鹼性氨基 -NH2 和羧酸基團 -COOH (其中R代表此處未指定的某個基團)。
由於胺基酸分子的這種特殊性,幾個這樣的分子可以相互結合形成以下類型的長鏈:
H2N – C(R1) – (C=O) – HN – C(R2) – (C=O) – HN – C(R3) …….. (C=O) – HN – C(Rn) – 唷……而且......看,這就是我如何「迷惑」你的,直到我描述了蛋白質是如何形成的☺! 在生物或生化系統中,事情比這更複雜一些,但我將在下面的段落中更詳細地解釋。
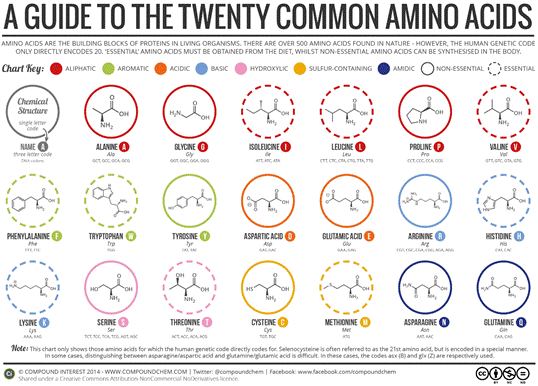
圖5 – 最常見的胺基酸
表1 – 胺基酸名稱、符號和分子的電荷
| 姓名 | 3個字母的符號 | 符號 1 個字母 | 極性 | mRNA 上的編碼組合 |
| 丙胺酸 | 翼 | 一個 | 中性的 | GCU、GCC、GCA、GCG |
| 精胺酸 | 精胺酸 | 右 | (+) | CGU、CGC、CGA、CGG、AGA、AGG |
| 天門冬胺酸 | 阿森 | 氮 | 中性的 | AAU、AAC |
| 酸性天門冬胺酸 | 天門冬胺酸 | D | (-) | 錯誤,GAC |
| 半胱胺酸 | 半胱胺酸 | C | 中性的 | 教資會、教資會 |
| 酸性谷氨酸 | 麩胺酸 | 乙 | (-) | GAA、GAG |
| 麩醯胺酸 | 麩醯胺酸 | 問 | 中性的 | CAA、CAG、GAA、GAC |
| 甘胺酸 | 甘胺酸 | G | 中性的 | GGU、GGC、GGA、GGG |
| 組胺酸 | 他的 | H | 10%+, 90%- | 中國農業大學、中國農業大學 |
| 異亮氨酸 | 和 | 我 | 中性的 | 哦,哦,哦 |
| 亮氨酸 | 亮氨酸 | L | 中性的 | UUA、UUG、CUU、CUC、CUA、CUG |
| 賴氨酸 | 賴氨酸 | K | (+) | AAA、AAG |
| 蛋胺酸 | 蛋胺酸 | 中號 | 中性的 | 八月 |
| 苯丙胺酸 | 苯丙胺酸 | F | 中性的 | UUU、UUC |
| 脯胺酸 | 專業版 | 磷 | 中性的 | CCU、CCC、CCA、CCG |
| 安詳 | 成為 | S | 中性的 | UCU、UCC、UCA、UCG、AGU、AGC |
| 蘇胺酸 | 蘇爾 | 時間 | 中性的 | ACU、ACC、ACA、ACG |
| 色氨酸 | 色氨酸 | 瓦 | 中性的 | UGG |
| 酪胺酸 | 提爾 | 是 | 中性的 | UAU、UAC |
| 纈胺酸 | 瓦爾 | V | 中性的 | GUU, GUC, GUA, GUG |
| 開始 | 八月 | |||
| 停止 | UAA、UAG、UGA |
如果在 mRNA 鏈上我們有(先前的例子):
| 一個 | U | G | C | G | G | C | 一個 | C | G | 一個 | U | U | U | C | C | U | G | 一個 | 一個 | C | C | C | G | U | G | 一個 |
用胺基酸的語言來說,這可以翻譯為(胺基酸的 3 個字元代碼的組合):
| 開始 | 精胺酸 | 他的 | 天門冬胺酸 | 苯丙胺酸 | 亮氨酸 | 阿森 | 專業版 | 停止 |
| 開始 | 右 | H | D | F | L | 氮 | 磷 | 停止 |
那是:
開始 – 精胺酸 – 組胺酸 – 天門冬胺酸 – 苯丙胺酸 – 亮胺酸 – 天門冬胺酸 – 脯胺酸 – STOP
或作為極性:
| 開始 | (+) | 10%(+)90%(-) | (-) | 中性的 | 中性的 | 中性的 | 中性的 | 停止 |
表 1 中的資訊以圖形方式總結在 圖6 來自以下:
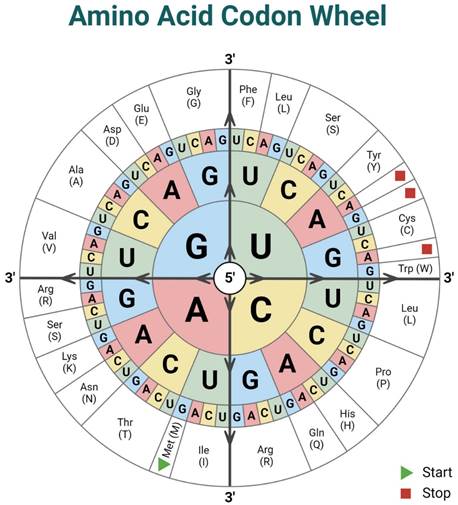
圖6 – 密碼子輪
為什麼我們如此堅持 DNA、RNA、mRNA、胺基酸或胺基酸序列(更廣泛地稱為蛋白質)?因為,這些胺基酸序列具有功能,該功能是由它們在空間上折疊或排列的方式賦予的。這種 3D 排列是根據該蛋白質中每個氨基酸的極性來完成的。由於細胞質中的環境是水性的(因此是極性的),因此 3D 結構的出現遵循幾個標準:
- 非極性胺基酸需要盡可能深地隱藏在結構內部,因為它不喜歡水;
- 極性胺基酸會盡可能靠近極性相反的胺基酸;
- 極性氨基酸會盡可能遠離具有相似極性的氨基酸。
這種空間構象決定了活性位點的出現,活性位點允許與另一種蛋白質、酵素(這使得過程運行得更快且能耗更少)、藥物中的活性物質分子偶聯。因為藥物(大多數時候)的工作原理是假鑰匙,適合打開蛋白質的某個青蛙/活性位點。
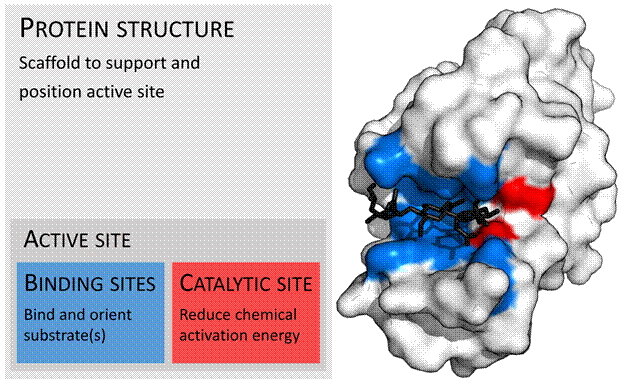
圖7 – 由於 3D 排列而出現的蛋白質活性位點
對於那些想要深入研究這個主題的人,我將“蛋糕上的糖果”留到了最後,並附上了一些解釋性視頻。
六.不是結論而是假設!
有一次,我曾說過: DNA 編碼精子受精卵子生長和發育所需的訊息,直到獲得功能齊全的有機體! 這是確定無疑的事情,可以看出 圖8。
從 Manuela Murariu 和 Gabi Drochioiu 於 2012 年發表在《Biosystems》雜誌(IF 2.0)上的一篇文章中,我了解了生物體的生物結構理論。他們談論生物學中的超分子概念,以及尤金·馬科夫斯基如何嘗試並部分成功地解釋生物系統中「死」和「活」之間的差異。
我想提出的假設是:
與蛋白質合成無關的訊息(在人類中-幾乎97%的DNA訊息在蛋白質合成中沒有作用,但也編碼胚胎生長發育到功能齊全的有機體階段的訊息, 圖8) 這些生物上層結構是否也編碼了生命與非生命之間的差異?這些編碼生物場嗎?
來這裡見你!
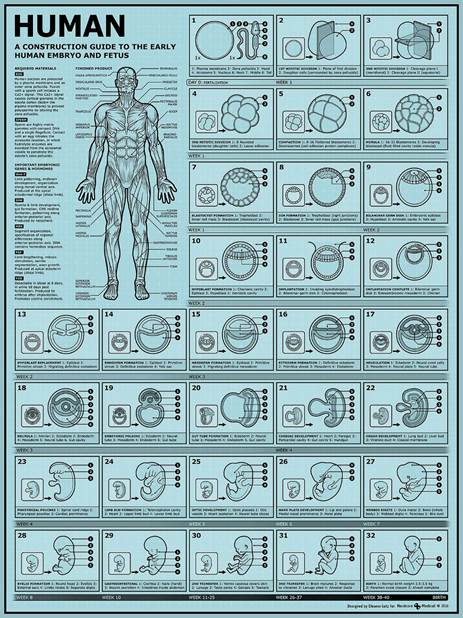
圖8 – 人類胚胎從受孕那一刻到出生的發育過程
七.選擇性參考書目
為了方便引用,同時也為了追蹤線上環境中的信息,我們選擇在文本中以二維碼的形式引用提供附加資訊的網頁。
Dawkins, R. – Gena Egoistă,布加勒斯特,技術編輯,2001 年(譯:Dan Crăciun)
Darymple,G.B.,《地球時代》,史丹佛大學,史丹佛大學出版社,1991 年;
Manhesa, G.、Allègre, C.J.、Dupréa, B.、Hamelin, B. – 基性-超基性層狀複合體的鉛同位素研究:關於地球年齡和原始地函特徵的推測 – 地球與行星科學快報,1980 年;
Dinu, V.、Trutia, E.、Popa-Cristea, E.、Popescu, A. – 醫學生物化學,小型論文,布加勒斯特,醫學版,1996 年
Murariu, M., Drochioiu, G. – 生命系統的生物結構理論 – 生物系統, 109-2, 126-132, 2012